
Weave
Wissensportal und Chat mit Quellenangabe
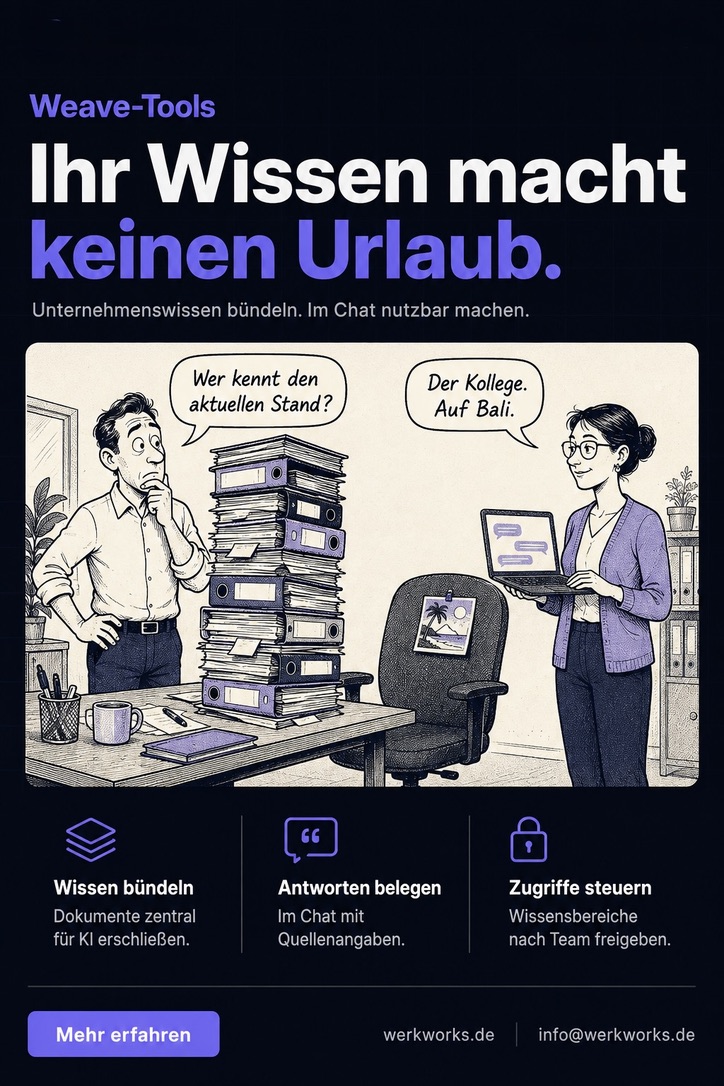
Wichtige Antworten stecken oft in Dokumenten, die niemand findet, oder im Wissen von Menschen, die gerade nicht erreichbar sind. Weave liest PDFs, Office-Dateien, Scans, E-Mails und Confluence-Seiten ein, bereitet sie als strukturierten Text auf und beantwortet Fragen im Chat. Die Quelle steht direkt neben jeder Antwort, damit sich jede Aussage nachvollziehen lässt.
Drei Regeln sorgen dafür, dass Wissen auffindbar bleibt, ohne die Kontrolle darüber zu verlieren: Ohne ausdrückliche Freigabe wird nichts indexiert. Berechtigungen greifen schon in der Suchabfrage, nicht erst danach. Und ohne Belege gibt es keine Antwort. Findet die Suche nichts, sagt der Chat genau das. Weave läuft auf Ihrer Hardware, das Sprachmodell ist austauschbar, externe Dienste sind im Auslieferungszustand nicht angebunden.
Kampagnenmotive
So funktioniert es
Agentenmodus: mehrere Subagenten recherchieren parallel
Bei komplexen Fragen zerlegt ein Planer die Frage in Teilfragen und startet dafür konfigurierte Subagenten, jeden mit eigenem Wissensbereich und Suchbudget. Der Chat zeigt den Fortschritt an, bevor die zusammengeführte Antwort mit Quellen erscheint.
Funktionen
- Wissensbereiche bündeln Dokumente; dort wird festgelegt, welche Gruppen sie lesen dürfen
- Freigabe als unveränderlicher Snapshot durch Eigentümer oder Administration; erst danach wird indexiert
- Hybride Suche: Vektorsuche über pgvector und PostgreSQL-Volltext, per RRF zusammengeführt und mit Cross-Encoder nachsortiert
- Rechte über Gruppen, ausgewertet in der Suchabfrage — außerhalb eines Wissensbereichs gibt es keine Treffer, auch keine versteckten
- Chat mit Quellenangabe zu jeder Antwort, mit derselben Anmeldung wie im Portal, lokal oder über OIDC
- Agentenmodus: bei komplexen Fragen recherchieren mehrere konfigurierte Subagenten parallel in ihren Wissensbereichen, mit Fortschrittsanzeige im Chat
- Bots über n8n mit Streaming für lang laufende Recherchen; MCP-Server und REST-Spiegel für list_collections und search mit kurzlebigen Rechten für Flows, dazu ein importierbarer n8n-Beispielflow für Weave-RAG mit einem externen OpenAI-kompatiblen LLM
- Technische Identitäten für externe MCP-/REST-Integrationen: ausdrücklich zugewiesene Wissensbereiche, einmalig sichtbares Token, Rotation, Widerruf und Audit-Log
- MCP-Anmeldung per SSO (Entra ID, Keycloak) für Clients wie VS Code: das Zugriffstoken wird einem vorhandenen Nutzer zugeordnet, die Rechte kommen aus seinen Gruppen in Weave
- Verwaltete Bots und Wissensbereiche für Gruppen; Rechte- und Inhaltsänderungen werden bis in Suche und Chat synchronisiert
- Freigegebene Dokumentversionen lassen sich zurückziehen und werden daraufhin aus dem Suchindex entfernt; „Neu indizieren“ steht je Dokument und Wissensbereich bereit
- Verarbeitungsprofile für OCR (PP-OCRv6, PP-StructureV3) und eingerichtete Vision-Modelle, mit erneuter Verarbeitung nach der Qualitätsprüfung
- Qualitätsstufen mit Begründung im Prüfportal, filterbar; Herkunft je Dokument und wer freigegeben hat sind sichtbar; Massenaktionen für mehrere Dokumente
- Confluence-Import mit Aktualisierung und Bildern direkt in Chat-Antworten, dazu einzelne .eml-Dateien als Quelle; unterstützte Anhänge werden mitverarbeitet
- Sicherung & Wiederherstellung: verschlüsselter Export aller Ingest-Daten, Wiederherstellung mit automatischem Reindex; Index-Wartung im Admin (Vektoren neu berechnen, Index aus Freigaben neu aufbauen)
- Selbst gehostet per Docker Compose oder als vollständige Plattform über das veröffentlichte Helm-Chart; optionale Embedding- und Reranking-Dienste laufen auf der CPU
- Horizontal skalierbar: jeder Dienst und beide Worker-Pools (OCR, Import/Freigabe) laufen mit mehreren Repliken, Dateien liegen in PostgreSQL statt auf einem gemeinsamen Volume, abgebrochene Aufträge werden automatisch neu eingestellt
Schreiben Sie mir
Ob Rückmeldung zu einem Produkt oder eine Anfrage zur Zusammenarbeit: Ihre Nachricht landet direkt bei mir. Ich melde mich selbst zurück.